
Gemini 4 argon
摘要
当生成式人工智能以惊人的速度向互联网倾倒文本和图像时,一个隐秘的生态危机正在浮现:下一代AI模型将不可避免地吞食上一代AI排出的“合成数据”。直觉上,既然AI生成的内容看起来通顺漂亮,用它们来扩充训练集似乎是一条免费的捷径。然而计算科学的研究揭示了一个残酷的数学事实——这种自我吞噬的循环会引发“模型崩溃”。就像生物界里的近亲繁殖或多次翻印的复印件一样,模型会迅速遗忘真实世界里丰富的长尾信息,一步步退化成单调、扭曲甚至完全胡言乱语的废品。
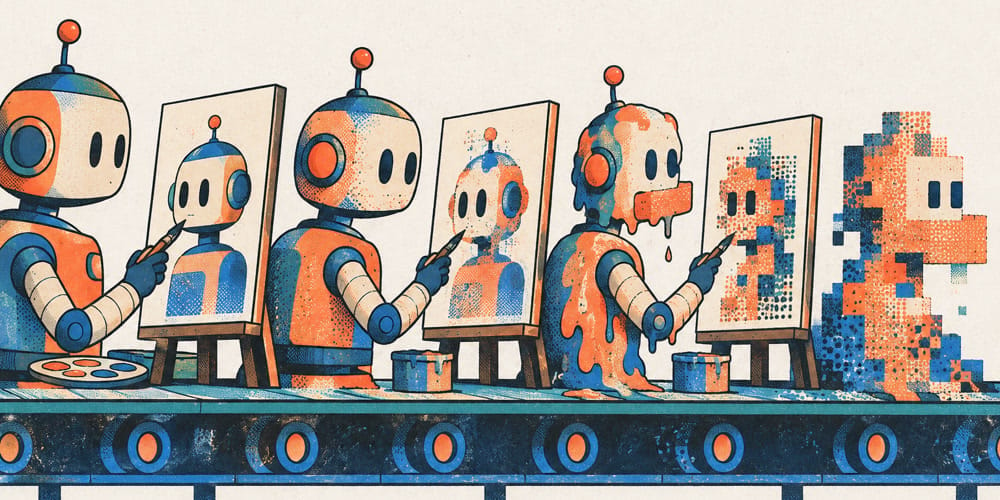
在伦敦或马德里的艺术博物馆里,如果你走近十六、十七世纪哈布斯堡王朝的皇室肖像画,会看到一张张极其相似又令人不安的脸:异常突出、几乎无法闭合的下颌,肥厚外翻的下唇,以及呆滞的眼神。这种被称为“哈布斯堡下巴”的生理畸形,是欧洲皇室为了维持血统纯正和政治版图,在近两百年间频繁进行叔侄、堂兄妹等近亲通婚的直接恶果。到了1700年,哈布斯堡西班牙分支的最后一位国王卡洛斯二世去世,他身患多种遗传病,终身不育,连咀嚼食物都极其困难——一个庞大的帝国分支,最终因为基因库里不再有外部新鲜基因的注入,在自我复制的死循环中彻底坍塌。
今天,位于旧金山、伦敦和北京的人工智能实验室,正面临着一场数字版本的“哈布斯堡危机”。
过去几年里,大语言模型(LLM)和图像生成模型的爆发,建立在一个不可再生的前提之上:人类在过去三十年间通过互联网积累的海量真实数据。无论是维基百科的词条、Reddit上的争吵、GitHub上的代码,还是无数摄影师上传的图片,都是人类心智与真实物理世界碰撞后的自然产物。然而,优质的人类文本存量正在触底。研究机构Epoch AI曾做过测算,按照目前大模型算力和训练集扩张的速度,互联网上高质量的公开人类语言数据将在未来几年内被彻底耗尽。
与此同时,AI生成的内容正在以指数级的速度反哺回互联网。从自动生成的SEO垃圾文章、社交媒体上的机器水军评论,到配图网站上泛滥的AI插画,互联网的“信噪比”正在发生永久性的改变。这意味着,当我们再去抓取网页数据来训练GPT-5、GPT-6或者未来的任何基础模型时,模型吞下去的将不再是纯粹的人类经验,而是大量由上一代AI生产出来的合成数据。
这听起来似乎不算太糟。毕竟,现在的AI写出的文章语法完美、逻辑通顺,画出的图像光影细腻,甚至比普通人类的平均水平还要高。用这些“优秀”的数据继续喂养下一代AI,难道不能实现左脚踩右脚、自我进化的飞轮吗?
牛津大学与剑桥大学的伊利亚·舒迈洛夫(Ilia Shumailov)等研究人员在2023年及随后发表于《自然》杂志的研究中,给这个乐观的设想泼了一盆冷水。他们证明,如果让生成式模型在没有外部真实数据干预的情况下,一代接一代地用前任生成的数据进行训练,模型非但不会进化,反而会患上一种不可逆的退化症。研究者将其命名为“模型崩溃”(Model Collapse)。
机器是如何一步步丢失“边缘记忆”的?
要理解模型崩溃,我们首先需要明白生成式AI到底在做什么。无论是写诗还是画画,AI并不是在“理解”世界,而是在拟合一个庞大的概率分布。
假设真实世界的人类语言是一座形态极其复杂的山脉。其中有高耸的主峰——那是我们日常最常使用的词汇、最主流的句式和最普遍的常识;同时,山脉四周还有漫长、崎岖、延伸向远方的山脚和幽谷——那是罕见的方言、生僻的历史典故、古怪的幽默感、少数群体的独特经验,以及极具创造力的反常规表达。在统计学上,主峰被称为分布的“头部”或均值附近,而那些漫长的山脚则被称为“长尾”(Tails)。
当第一代AI模型(我们称之为模型0)在真实的人类数据上进行训练时,它试图用数学公式把这座山脉的形状描摹下来。受限于模型大小和算力,它不可能记住每一粒沙子,但能大致还原山脉的轮廓。接下来,我们让模型0生成一批新数据,用来训练下一代模型(模型1)。
灾难就是从“生成”这一步开始的。
模型在生成内容时,本质上是在它学到的概率分布里进行“抽样”。因为只能抽取有限的样本(比如生成十亿个词),根据基本的概率法则,出现频率高的事件(主峰)被抽中的概率极大,而原本就极其罕见的事件(远处的山脚)在一次有限的抽样中,很有可能一次都没被抽中。这在统计学上被称为“有限采样误差”或统计近似误差。
不仅如此,为了让AI说话更靠谱、不至于满嘴胡话,工程师在让模型生成文本时,通常会人为调低“温度”(Temperature),或者使用Top-p、Top-k等截断采样策略。这些技术的本质,就是强行砍掉那些概率极低的生僻选项,逼着模型只从概率最高、最安全的词汇里做选择。
于是,模型0吐出来的这批合成数据,虽然表面上依然通顺流畅,但它的内在地形已经变了:原本漫长崎岖的山脚被削平了,所有的石头都被堆到了主峰上。
当模型1吃下这批被削去长尾的数据进行训练时,它眼中的世界就只剩下了那座主峰。等模型1训练完毕,再让它去生成数据喂给模型2时,模型1又会在自己已经缩水的分布里再次进行有限抽样,把新的边缘再次削平。如此循环往复,不需要几十代,往往只需要五到十个世代的迭代,整座山脉就会坍缩成一根孤零零的、极其尖锐的柱子。
舒迈洛夫的团队将这个过程分为两个阶段:早期模型崩溃和晚期模型崩溃。
在早期崩溃阶段,模型丢失的是“尾部信息”(Tails)。这时候你和它聊天,可能察觉不到任何异常,它依然能对答如流地写公文、写常见代码。但它已经彻底丧失了多样性,变得极度平庸和刻板。那些小众的知识、边缘群体的视角、罕见的语法结构,在它的世界里被永久抹去了。这是一种隐蔽的衰退,因为现有的许多AI评测基准只考核主流任务,一个丢失了长尾的模型甚至可能在考试中拿到更高的平均分。
而到了晚期崩溃阶段,量变引发质变。随着方差进一步缩小,加上神经网络自身的函数近似误差在迭代中被不断放大,整个概率分布不仅缩成一团,连中心位置都会发生剧烈的漂移。原本平滑的语言规律彻底碎裂,模型陷入不可挽回的错乱。
在研究团队做的一个经典实验里,他们用一个语言模型去学习关于英国中世纪建筑的历史文本,然后让它生成文本训练下一代。前几代模型还能讨论“十四世纪的教堂拱顶”;到了第五代,模型开始翻来覆去地车轱辘话,内容变成了空洞的套话;而到了第九代,当被要求继续续写建筑历史时,模型输出了一长串荒诞的胡言乱语——它开始用各种颜色的“野兔尾巴”(jackrabbits)来刷屏,比如“金黄色的野兔尾巴、白色的野兔尾巴、黑色的野兔尾巴……”。
同样的悲剧也发生在图像模型上。用扩散模型生成人脸,再拿这些人脸去训练下一代模型,几轮之后,画面上所有人脸的皮肤纹理、光影细节和独特神态全部消失,最后坍缩成一团模糊、诡异、布满网格状噪点的色块;如果是在手写数字数据集上做实验,所有的数字“0”到“9”经过十几代自我繁衍后,都会融合成一个长得既像“8”又像一团墨迹的同质化符号。
复印机的复印机,与被锁死的生态位
这听起来非常像我们在日常生活中经历过的“复印机效应”或“传话游戏”。当你把一张照片放进复印机,印出第一张黑白稿,再把这张黑白稿放进去印第二张……印到第十次时,原本丰富的中间色调(灰阶)会全部消失,稍微浅一点的灰色变成纯白,稍微深一点的灰色变成死黑,整张纸上只剩下高对比度的狰狞斑块。数字图像在反复有损压缩(所谓“电子包浆”)时也是如此,每次保存都会丢掉一点高频细节,并把压缩算法自身的伪影(噪点)当成真实图像的一部分固定下来,并在下一次压缩中将其放大。
合成数据训练的本质,就是用模型去压缩真实世界,然后再对压缩后的产物进行二次压缩。每一次迭代,模型都在强化自己对世界既有的偏见,同时抹杀那些它没能完全理解的微妙细节。
这种现象一旦在互联网层面蔓延,带来的不仅仅是技术停滞,更是一场认识论层面的危机。
在人类历史中,公元1945年是一个特殊的物理分界线。在那一年,人类引爆了第一颗原子弹,随后数十年的大气层核试验将微量的放射性同位素(如碳-14和铯-137)散布到了全球大气中。从那以后生产的每一块钢铁,在冶炼时都会因为鼓入空气而混入微量辐射。因此,当今天的物理学家需要制造极其灵敏的盖革计数器或暗物质探测器时,他们无法使用现代钢铁,只能去海底打捞一战或二战时期沉没的古老战舰残骸——只有那些被称为“低背景钢”的沉船铁板,才保留着核时代之前纯净的物理基底。
在数字世界里,2022年底ChatGPT的发布,就是我们的“三位一体”核试验时刻。
2022年之前的互联网数据,成了极其珍贵的“低背景数据”。在那之前,虽然网上也有垃圾信息和自动爬虫,但绝大多数连贯的文本依然是人类大脑神经元的直接投射。而在2023年之后,整个互联网的大气层已经被生成式AI的“放射性尘埃”永久污染了。
更糟糕的是,这种污染甚至正在摧毁那些致力于保存人类真实记录的阵地。许多开源社区、百科全书项目、甚至学术期刊的审稿系统,都已经被AI生成的长篇大论所淹没。更具讽刺意味的是,用于训练AI的许多人工标注外包平台(如亚马逊的Mechanical Turk),现在充满了使用ChatGPT来快速完成标注任务的工人。研究人员花高价雇佣“人类”来清洗数据、给模型做人类反馈强化学习(RLHF),结果买回来的依然是AI生成的数据。这形成了一个密不透风的闭环。
合成数据真的毫无价值吗?
那么,这是否意味着人工智能的发展已经被锁死在了一条死胡同里,合成数据彻底是一剂毒药?
事实并非如此绝对。模型崩溃的发生,有一个至关重要的前提条件:无差别的、未经筛选的自我吞噬。也就是说,把AI生成的东西原封不动地当成绝对真理喂回去,才会导致坍塌。
在计算机科学中,有一类合成数据不仅没有导致崩溃,反而造就了AI史上最辉煌的胜利——那就是DeepMind的AlphaGo Zero。初代AlphaGo还需要学习人类棋手的几十万盘棋谱,但到了AlphaGo Zero,工程师干脆扔掉了所有人类棋谱,只告诉它围棋的基本规则,让它自己跟自己下棋(即100%使用合成数据)。短短几天后,它就彻底碾压了所有人类冠军和它的前辈。
为什么AlphaGo左右互搏几百万次不会发生“模型崩溃”,而大语言模型自我迭代九次就会开始胡言乱语?
核心差异在于是否存在一个外部的、客观的验证器(Verifier)。
围棋是一个规则绝对清晰、胜负完全客观的封闭系统。当AlphaGo自己跟自己下出一盘臭棋时,棋盘的胜负规则会冷酷地给出一个“输”的信号。模型生成的垃圾数据会被这个客观标准无情淘汰,只有那些真正能够赢棋的高质量探索才会被保留下来,成为下一代模型的养料。换句话说,围棋规则本身充当了那个永不枯竭的“外部真实世界”。
同样的逻辑也适用于今天的AI写代码和解数学题。如果我们让大模型生成一万道数学题的解法,或者一万段Python代码,我们不需要全部照单全收。我们可以把代码扔进编译器里跑一下,或者把数学证明放进形式化验证工具(如Lean)里检验。跑不通的代码、逻辑断裂的证明会被直接扔进垃圾桶;只有那些编译通过、成功解决问题的合成数据,才会被挑选出来用于训练下一代模型。在这类拥有“黄金验证标准”的领域,合成数据不仅不会引发崩溃,反而是突破人类数据瓶颈的最强利器。
此外,研究还发现,只要在训练每一代新模型时,不彻底丢弃最初的“人类原始数据”,而是将一定比例的真实人类数据与AI合成数据混合在一起,模型崩溃的速度就会大幅放缓,甚至可以被有效遏制。真实数据就像定海神针一样,死死拽住概率分布的长尾,防止整个模型向中心坍缩。
真正的困境在于那些没有客观验证器的人类核心领域——文学、历史、哲学、艺术、日常闲聊、社会评论,以及那些无法用编译器报错来衡量的复杂现实生活。
你无法写一段程序去自动验证一首诗是否真的触动了人类灵魂的深处,也无法用编译器去判断一段关于小众历史事件的叙述是否抹杀了某个边缘群体的真实痛苦。在这些领域,如果我们为了省事,用另一个AI裁判去筛选AI生成的数据,那么裁判本身也带有同样的分布偏见——一个已经丢失了长尾的裁判,只会给那些平庸、安全、符合主流套路的生成结果打出高分,从而加速整个系统的同质化。
这也解释了为什么今天科技巨头们一方面在狂热地研究合成数据技术,另一方面又在挥舞着支票簿,以前所未有的高价去购买新闻集团、Reddit、出版社甚至影视公司的独家历史档案。那些积满灰尘的旧报纸、十年前论坛上人类笨拙的争吵、甚至人们随手拍下的构图糟糕的生活照,突然间变成了数字时代最昂贵的矿藏。
因为机器可以不知疲倦地对已知的常识进行排列组合,但它无法替人类去经历一次真实的心碎,无法替人类在泥泞的现实中犯下荒唐却极具启发性的错误,也无法凭空捏造出那些处于正态分布最边缘的、古怪而耀眼的灵光一现。一旦切断了与这个粗糙、混乱但充满意外的真实世界的脐带,再庞大的硅基大脑,最终也只能在自己的倒影里,一遍遍描摹出那个日益扭曲的“哈布斯堡下巴”。